排序简介

排序算法(英语:Sorting algorithm)是一种将一组特定的数据按某种顺序进行排列的算法。排序算法多种多样,性质也大多不同。

性质

稳定性

稳定性是指相等的元素经过排序之后相对顺序是否发生了改变。

拥有稳定性这一特性的算法会让原本有相等键值的纪录维持相对次序,即如果一个排序算法是稳定的,当有两个相等键值的纪录 RR 和 SS,且在原本的列表中 RR 出现在 SS 之前,在排序过的列表中 RR 也将会是在 SS 之前。

基数排序、计数排序、插入排序、冒泡排序、归并排序是稳定排序。

选择排序、堆排序、快速排序不是稳定排序。

时间复杂度

时间复杂度用来衡量一个算法的运行时间和输入规模的关系,通常用 OO 表示。

简单计算复杂度的方法一般是统计“简单操作”的执行次数,有时候也可以直接数循环的层数来近似估计。

时间复杂度分为最优时间复杂度、平均时间复杂度和最坏时间复杂度。OI 竞赛中要考虑的一般是最坏时间复杂度,因为它代表的是算法运行水平的下界,在评测中不会出现更差的结果了。

基于比较的排序算法的时间复杂度下限是 O(nlog⁡n)O(n\log n) 的。

当然也有不是 O(nlog⁡n)O(n\log n) 的。例如,计数排序的时间复杂度是 O(n+w)O(n+w),其中 ww 代表输入数据的值域大小。

以下是几种排序算法的比较。

空间复杂度

与时间复杂度类似,空间复杂度用来描述算法空间消耗的规模。一般来说,空间复杂度越小,算法越好。

外部链接


选择排序

选择排序(英语:Selection sort)是一种简单直观的排序算法。它的工作原理是每次找出第 ii 小的元素(也就是 Ai..nA_{i..n} 中最小的元素),然后将这个元素与数组第 ii 个位置上的元素交换。

选择排序

性质

稳定性

由于 swap(交换两个元素)操作的存在,选择排序是一种不稳定的排序算法。

时间复杂度

选择排序的最优时间复杂度、平均时间复杂度和最坏时间复杂度均为 O(n2)O(n^2)。

代码实现

伪代码

1Input. An array A consisting of n elements.2Output. A will be sorted in nondecreasing order.3Method. 4for i←1 to n−15ith←i6for j←i+1 to n7if A[j]<A[ith]8ith←j9swap A[i] and A[ith]\begin{array}{ll} 1 & \textbf{Input. } \text{An array } A \text{ consisting of }n\text{ elements.} \\ 2 & \textbf{Output. } A\text{ will be sorted in nondecreasing order.} \\ 3 & \textbf{Method. } \\ 4 & \textbf{for } i\gets 1\textbf{ to }n-1\\ 5 & \qquad ith\gets i\\ 6 & \qquad \textbf{for }j\gets i+1\textbf{ to }n\\ 7 & \qquad\qquad\textbf{if }A[j]<A[ith]\\ 8 & \qquad\qquad\qquad ith\gets j\\ 9 & \qquad \text{swap }A[i]\text{ and }A[ith]\\ \end{array}

C++

1
2
3
4
5
6
7
8
9
10
11
void selection_sort(int a[], int n) {
for (int i = 1; i < n; ++i) {
int ith = i;
for (int j = i + 1; j <= n; ++j) {
if (a[j] < a[ith]) {
ith = j;
}
}
swap(a[i], a[ith]);
}
}

冒泡排序

冒泡排序(英语:Bubble sort)是一种简单的排序算法。由于在算法的执行过程中,较小的元素像是气泡般慢慢「浮」到数列的顶端,故叫做冒泡排序。

工作原理

它的工作原理是每次检查相邻两个元素,如果前面的元素与后面的元素满足给定的排序条件,就将相邻两个元素交换。当没有相邻的元素需要交换时,排序就完成了。

经过 ii 次扫描后,数列的末尾 ii 项必然是最大的 ii 项,因此冒泡排序最多需要扫描 n−1n-1 遍数组就能完成排序。

性质

稳定性

冒泡排序是一种稳定的排序算法。

稳定性 (stability) 是对排序算法更为细致的要求, 重在考查算法对重复元素的处理效果。

具体地, 在将向量A转换为有序向量S之后, 设 A[i]A[i] 对应于 S[ki]S\left[k_{i}\right] 。若对于 AA 中每一对重复元素 A[i]=A[j]A[i]=A[j] (相应地 S[ki]=S[kj]S\left[k_{i}\right]=S\left[k_{j}\right] ,都有 i<ji<j 当且仅当 ki<kjk_{i}<k_{j}, 则称该排序算法是稳定算法(stable algorithm)。简而言之, 稳定算法的特征是, 重复元素之间的相对次序在排序前后保持一致。反之, 不具有这一特征的排序算法都是不稳定算法(unstable algorithm)。

比如, 依此标准反观起泡排序可以发现, 该算法过程中元素相对位置有所调整的唯一可能是,
某元素 elem[i−1]elem[i - 1] 严格大于其后继 elem[i]elem[i] 。也就是说, 在这种亦步亦趋的交换过程中, 重复元素虽可能相互靠拢,但绝对不会相互跨越。由此可知,起泡排序属于稳定算法。

稳定的排序算法,可用以实现同时对多个关键码按照字典序的排序。比如,基数排序算法的正确性,就完全建立在桶排序稳定性的基础之上。

时间复杂度

在序列完全有序时,冒泡排序只需遍历一遍数组,不用执行任何交换操作,时间复杂度为 O(n)O(n)。

在最坏情况下,冒泡排序要执行 (n−1)n2\frac{(n-1)n}{2} 次交换操作,时间复杂度为 O(n2)O(n^2)。

冒泡排序的平均时间复杂度为 O(n2)O(n^2)。

代码实现

伪代码

1Input. An array A consisting of n elements.2Output. A will be sorted in nondecreasing order stably.3Method. 4flag←Trueflag: need sort5while flag6flag←False7for i←1 to n−18if A[i]>A[i+1]9flag←True10Swap A[i] and A[i+1]11–n\begin{array}{ll} 1 & \textbf{Input. } \text{An array } A \text{ consisting of }n\text{ elements.} \\ 2 & \textbf{Output. } A\text{ will be sorted in nondecreasing order stably.} \\ 3 & \textbf{Method. } \\ 4 & flag\gets True \qquad\qquad \text{\\\\ flag: need sort}\\ 5 & \textbf{while }flag\\ 6 & \qquad flag\gets False\\ 7 & \qquad\textbf{for }i\gets1\textbf{ to }n-1\\ 8 & \qquad\qquad\textbf{if }A[i]>A[i + 1]\\ 9 & \qquad\qquad\qquad flag\gets True\\ 10 & \qquad\qquad\qquad \text{Swap } A[i]\text{ and }A[i + 1]\\ 11 & \qquad \text{--}n \end{array}

C++

1
2
3
4
5
6
7
8
9
10
11
12
13
void bubble_sort(int a[], int n) {
bool sorted = false; //整体排序标志,首先假定尚未排序
while (!sorted) { //在尚未确定已全局排序之前,逐趟进行扫描交换
sorted = true; //假定已经排序
for (int i = 1; i < n; ++i) {
if (a[i] > a[i + 1]) {
sorted = false
swap(a[i], a[i + 1]); //因整体排序不能保证,需要清除排序标志
}
}
--n; //至此末元素必然就位,故可以缩短待排序序列的有效长度
}
}

插入排序

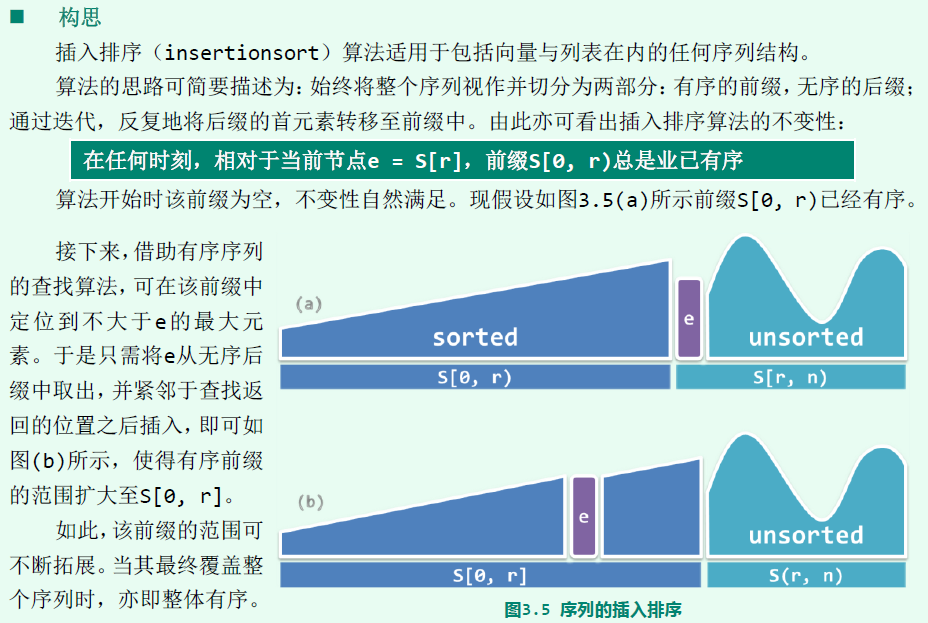
插入排序(英语:Insertion sort)是一种简单直观的排序算法。它的工作原理为将待排列元素划分为“已排序”和“未排序”两部分,每次从“未排序的”元素中选择一个插入到“已排序的”元素中的正确位置。

一个与插入排序相同的操作是打扑克牌时,从牌桌上抓一张牌,按牌面大小插到手牌后,再抓下一张牌。

插入排序

性质

稳定性

插入排序是一种稳定的排序算法。

时间复杂度

插入排序的最优时间复杂度为 O(n)O(n),在数列几乎有序时效率很高。

插入排序的最坏时间复杂度和平均时间复杂度都为 O(n2)O(n^2)。

代码实现

伪代码

1Input. An array A consisting of n elements.2Output. A will be sorted in nondecreasing order stably.3Method. 4for i←2 to n5key=A[i]6Insert A[i] into the sorted sequence A[1⋯i−1]7j=i−18while j>0 and A[j]>key9A[j+1]=A[j]10j=j−111A[j+1]=key\begin{array}{ll} 1 & \textbf{Input. } \text{An array } A \text{ consisting of }n\text{ elements.} \\ 2 & \textbf{Output. } A\text{ will be sorted in nondecreasing order stably.} \\ 3 & \textbf{Method. } \\ 4 & \textbf{for } i\gets 2\textbf{ to }n\\ 5 & \qquad key = A[i]\\ 6 & \qquad \text{\\\\Insert } A[i] \text{ into the sorted sequence } A[1 \cdots i-1]\\ 7 & \qquad j = i-1\\ 8 & \qquad\textbf{while }j>0\textbf{ and }A[j]>key\\ 9 & \qquad\qquad A[j + 1] = A[j]\\ 10 & \qquad\qquad j = j - 1\\ 11 & \qquad A[j + 1] = key \end{array}

C++

1
2
3
4
5
6
7
8
9
10
11
12
void insertion_sort(int a[], int n) {
// 对 a[1],a[2],...,a[n] 进行插入排序
for (int i = 2; i <= n; ++i) {
int key = a[i];
int j = i - 1;
while (j > 0 && a[j] > key) {
a[j + 1] = a[j];
--j;
}
a[j + 1] = key;
}
}

计数排序

1
注意:本页面要介绍的不是基数排序。

计数排序(英语:Counting sort)是一种线性时间的排序算法。

工作原理

计数排序的工作原理是使用一个额外的数组 CC,其中第 ii 个元素是待排序数组 AA 中值等于 ii 的元素的个数,然后根据数组 CC 来将 AA 中的元素排到正确的位置。

它的工作过程分为三个步骤:

  1. 计算每个数出现了几次;
  2. 求出每个数出现次数的前缀和;
  3. 利用出现次数的前缀和,从右至左计算每个数的排名。

计数排序

算法导论详解

计数排序假设 nn 个输入元素中的每一个都是在 00 到 kk 区间内的一个整数, 其中 kk 为某个整 数。当 k=O(n)k=O(n) 时, 排序的运行时间为 Θ(n)\Theta(n) 。

计数排序的基本思想是:对每一个输入元素 xx, 确定小于 xx 的元素个数。利用这一信息, 就 可以直接把 xx 放到它在输出数组中的位置上了。例如, 如果有 17 个元素小于 xx, 则 xx 就应该在第 18 个输出位置上。当有几个元素相同时, 这一方案要略做修改。因为不能把它们放在同一个输出位置上。

在计数排序算法的代码中, 假设输入是一个数组 A[1.n]A[1 . n] , A.length=nA.length = n 。我们还需要两个数组: B[1..n]B[1 . . n] 存放排序的输出, C[0..k]C[0 . . k] 提供临时存储空间。

 COUNTING-SORT (A,B,k)1let C[0…k] be a new array 2for i=0 to k3C[i]=04for j=1 to A. length 5C[A[j]]=C[A[j]]+16//  C[i] now contains the number of elements equal to i.7for i=1 to k8C[i]=C[i]+C[i−1]9//  C[i] now contains the number of elements less than or equal to i.10for j=A. length downto 111B[C[A[j]]]=A[j]12C[A[j]]=C[A[j]]−113return B\begin{aligned} &\text { COUNTING-SORT }(A, B, k) \\ &\begin{array}{rl} 1 & \text {let } C[0\dots k] \text { be a new array } \\ 2 & \text {for } i=0 \text { to } k \\ 3 & \qquad C[i]=0 \\ 4 & \text {for } j=1 \text { to } A \text {. length } \\ 5 & \qquad C[A[j]]=C[A[j]]+1 \\ 6 & // \;C[i] \text { now contains the number of elements equal to } i . \\ 7 & \text {for } i=1 \text { to } k \\ 8 & \qquad C[i]=C[i]+C[i-1] \\ 9 & // \;C[i] \text { now contains the number of elements less than or equal to } i . \\ 10 & \text {for } j=A . \text { length downto } 1 \\ 11 & \qquad B[C[A[j]]]=A[j] \\ 12 & \qquad C[A[j]]=C[A[j]]-1\\ 13 & \text{return } B \end{array} \end{aligned}

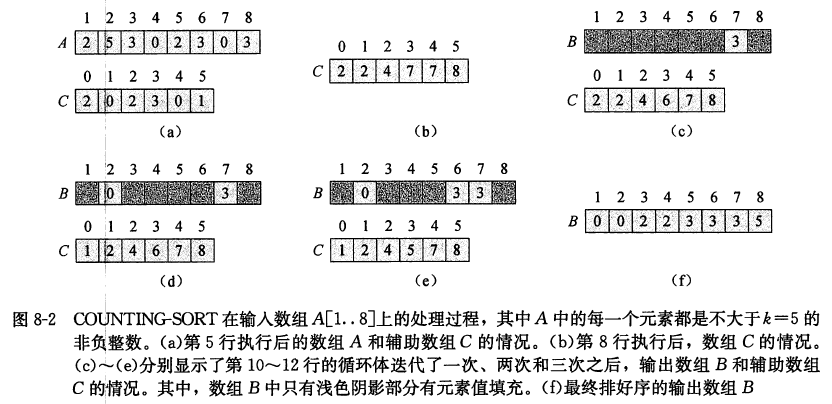
下图展示了计数排序的运行过程。在第 2∼32 \sim 3 行 for 循环的初始化操作之后, 数组 CC 的值全 被置为 0 ; 第 4∼54 \sim 5 行的 for 循环遍历每一个输入元素。如果一个输入元素的值为 ii, 就将 C[i]C[i] 值加 1 。于是, 在第 5 行执行完后, C[i]C[i] 中保存的就是等于 ii 的元素的个数, 其中 i=0,1,⋯ ,ki=0,1, \cdots, k 。 第 7∼87 \sim 8 行通过加总计算确定对每一个 i=0,1,⋯ ,ki=0,1, \cdots, k, 有多少输入元素是小于或等于 ii 的。

最后, 在第 10∼1210 \sim 12 行的 for 循环部分, 把每个元素 A[j]A[j] 放到它在输出数组 BB 中的正确位 置上。如果所有 nn 个元素都是互异的, 那么当第一次执行第 10 行时, 对每一个 A[j]A[j] 值来说, C[A[j]]C[A[j]] 就是 A[j]A[j] 在输出数组中的最终正确位置。这是因为共有 C[A[j]]C[A[j]] 个元素小于或等于 A[j]A[j] 。因为所有的元素可能并不都是互异的, 所以, 我们每将一个值 A[j]A[j] 放人数组 BB 中以后, 都要将 C[A[j]]C[A[j]] 的值减 1 。这样, 当遇到下一个值等于 A[j]A[j] 的输入元素 (如果存在) 时, 该元素可以直接被放到输出数组中 A[j]A[j] 的前一个位置上。

计数排序的时间代价是多少呢? 第 2∼32 \sim 3 行的 for 循环所花时间为 Θ(k)\Theta(k), 第 4∼54 \sim 5 行的 for 循环所花时间为 Θ(n)\Theta(n), 第 7∼87 \sim 8 行的 for 循环所花时间为 Θ(k)\Theta(k), 第 10∼1210 \sim 12 行的 for 循环所花时间为 Θ(n)\Theta(n) 。这样, 总的时间代价就是 Θ(k+n)\Theta(k+n) 。在实际工作中, 当 k=O(n)k=O(n) 时, 我们一般会采用计数排序, 这时的运行时间为 Θ(n)\Theta(n) 。

计数排序的下界优于我们在 8.18.1 节中所证明的 Ω(nlg⁡n)\Omega(n \lg n), 因为它并不是一个比较排序算法。事实上, 它的代码中完全没有输入元素之间的比较操作。相反, 计数排序是使用输入元素的实际值来确定其在数组中的位置。当我们脱离了比较排序模型的时候, Ω(nlg⁡n)\Omega(n \lg n) 这一下界就不再适用了。

计数排序的一个重要性质就是它是稳定的: 具有相同值的元素在输出数组中的相对次序与它们在输入数组中的相对次序相同。也就是说, 对两个相同的数来说, 在输入数组中先出现的数, 在输出数组中也位于前面。通常, 这种稳定性只有当进行排序的数据还附带卫星数据时才比 较重要。计数排序的稳定性很重要的另一个原因是:计数排序经常会被用作基数排序算法的一个子过程。我们将看到, 为了使基数排序正确运行, 计数排序必须是稳定的。

性质

稳定性

计数排序是一种稳定的排序算法。

时间复杂度

计数排序的时间复杂度为 O(n+w)O(n+w),其中 ww 代表待排序数据的值域大小。

代码实现

伪代码

1Input. An array A consisting of n positive integers no greater than w.2Output. Array A after sorting in nondecreasing order stably.3Method. 4for i←0 to w5cnt[i]=06for i←1 to n7cnt[A[i]]=cnt[A[i]]+18for i←1 to w9cnt[i]=cnt[i]+cnt[i−1]10for i←n downto 111B[cnt[A[i]]]=A[i]12cnt[A[i]]=cnt[A[i]]−113return B\begin{array}{ll} 1 & \textbf{Input. } \text{An array } A \text{ consisting of }n\text{ positive integers no greater than } w. \\ 2 & \textbf{Output. } \text{Array }A\text{ after sorting in nondecreasing order stably.} \\ 3 & \textbf{Method. } \\ 4 & \textbf{for }i\gets0\textbf{ to }w\\ 5 & \qquad cnt[i] = 0\\ 6 & \textbf{for }i\gets1\textbf{ to }n\\ 7 & \qquad cnt[A[i]] = cnt[A[i]]+1\\ 8 & \textbf{for }i\gets1\textbf{ to }w\\ 9 & \qquad cnt[i] = cnt[i]+cnt[i-1]\\ 10 & \textbf{for }i\gets n\textbf{ downto }1\\ 11 & \qquad B[cnt[A[i]]] = A[i]\\ 12 & \qquad cnt[A[i]] = cnt[A[i]]-1\\ 13 & \textbf{return } B \end{array}

C++

1
2
3
4
5
6
7
8
9
10
11
12
// C++ Version
const int N = 100010;
const int W = 100010;

int n, w, a[N], cnt[W], b[N];

void counting_sort() {
memset(cnt, 0, sizeof(cnt));
for (int i = 1; i <= n; ++i) ++cnt[a[i]];
for (int i = 1; i <= w; ++i) cnt[i] += cnt[i - 1];
for (int i = n; i >= 1; --i) b[cnt[a[i]]--] = a[i]; //如果b从0开始存储,则--cnt[a[i]]
}

参考资料与注释

计数排序 - 维基百科,自由的百科全书


基数排序

1
2
本页面要介绍的不是 **计数排序**。
**基数排序** ≠ 计数排序

基数排序(英语:Radix sort)是一种非比较型的排序算法,最早用于解决卡片排序的问题。

工作原理

它的工作原理是将待排序的元素拆分为 kk 个关键字(比较两个元素时,先比较第一关键字,如果相同再比较第二关键字……),然后先对第 kk 关键字进行稳定排序,再对第 k−1k-1 关键字进行稳定排序,再对第 k−2k-2 关键字进行稳定排序……最后对第一关键字进行稳定排序,这样就完成了对整个待排序序列的稳定排序。

基数排序

基数排序需要借助一种 稳定算法 完成内层对关键字的排序。

通常而言,基数排序比基于比较的排序算法(比如快速排序)要快。但由于需要额外的内存空间,因此当内存空间稀缺时,原地置换算法(比如快速排序)或许是个更好的选择。

基数排序的正确性可以参考 《算法导论(第三版)》第 8.3-3 题的解法 或自行理解。

算法导论详解

基数排序 (radix sort) 是一种用在卡片排序机上的算法, 现在你只能在博物馆找到这种卡片 排序机了。一张卡片有 80 列, 在每一列上机器可以选择在 12 个位置中的任一处穿孔。通过机械操作, 我们可以对排序机“编程”来检查每个卡片中的给定列, 然后根据穿孔的位置将它们分别放入 12 个容器中。操作员就可以逐个容器地来收集卡片, 其中第一个位置穿孔的卡片在最上面, 其次是第二个位置穿孔的卡片, 依此类推。

对十进制数字来说, 每列只会用到 10 个位置 (另两个位置用于编码非数值字符)。一个 dd 位 数将占用 dd 列。因为卡片排序机一次只能查看一列, 所以要对 nn 张卡片上的 dd 位数进行排序, 就需要设计一个排序算法。

从直观上来看, 你可能会觉得应该按 最高有效位 进行排序, 然后对得到的每个容器递归地进行排序, 最后再把所有结果合并起来。遗憾的是, 为了排序一个容器中的卡片, 10 个容器中的 9 个都必须先放在一边。这一过程产生了许多要保存的临时卡片 (见练习 8.3-5)。

与人们直观感受相悖的是, 基数排序是先按 最低有效位 进行排序来解决卡片排序问题的。 然后算法将所有卡片合并成一叠, 其中 0 号容器中的卡片都在 1 号容器中的卡片之前, 而 1 号容
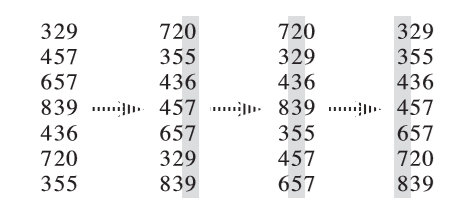
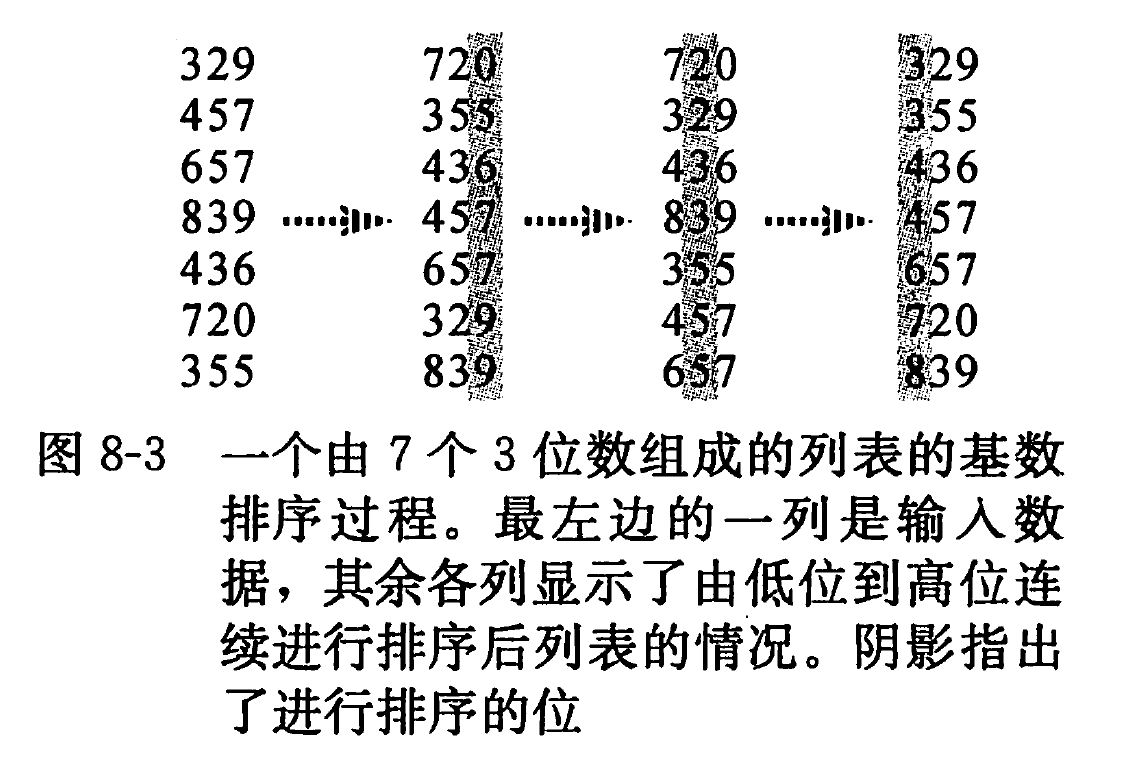
器中的卡片又在 2 号容器中的卡片前面, 依此类推。之后, 用同样的方法按次低有效位对所有的卡片进行排序, 并把排好的卡片再次合并成一叠。重复这一过程, 直到对所有的 dd 位数字都进行了排序。此时, 所有卡片已按 dd 位数完全排好序。所以, 对这一叠卡片的排序仅需要进行 dd 轮。下图说明了“一叠” 7 张 3 位数卡片的基数排序过程。

为了确保基数排序的正确性, 一位数排序算法必须是稳定的。卡片排序机所执行的排序是稳定的, 但操作员必须确保卡片从容器中被取出时不改变顺序, 即使一个容器中的所有卡片在该位 都是相同的数字也要确保这一点。

在一台典型的串行随机存取计算机上, 我们有时会用基数排序来对具有多关键字域的记录进行排序。例如, 我们希望用三个关键字(年、月和日)来对日期进行排序。对这个问题, 我们可以使用基于特殊比较函数的排序算法: 给定两个日期, 先比较年, 如果相同, 再比较月, 如果还是相同, 就比较日。我们也可以采用另一种方法, 用一种稳定排序算法对这些信息进行三次排 序: 先日, 再月, 最后是年。

基数排序的代码是非常直观的。在下面的代码中, 我们假设 nn 个 dd 位的元素存放在数组 AA 中, 其中第 1 位是最低位, 第 dd 位是最高位。

 RADIX-SORT (A,d)1for i=1 to d2use a stable sort to sort array A on digit i\begin{aligned} &\text { RADIX-SORT }(A, d) \\ &\begin{array}{rl} 1 & \text {for } i=1 \text { to } d \\ 2 & \qquad \text {use a stable sort to sort array } A \text { on digit } i \end{array} \end{aligned}

引理 8.3: 给定 nn 个 dd 位数, 其中每一个数位有 kk 个可能的取值。如果 RADIX-SORT 使用的稳定排序方法耗时 Θ(n+k)\Theta(n+k), 那么它就可以在 Θ(d(n+k))\Theta(d(n+k)) 时间内将这些数排好序。

证明: 基数排序的正确性可以通过对被排序的列进行归纳而加以证明。对算法时间代价的分析依赖于所使用的稳定的排序算法。当每位数字都在 00 到 k−1k-1 区间内(这样它就有 kk 个可能的取值), 且 kk 的值不太大的时候, 计数排序是一个好的选择。对 nn 个 dd 位数来说, 每一轮排序耗时 Θ(n+k)\Theta(n+k) 。共有 dd 轮, 因此基数排序的总时间为 Θ(d(n+k))\Theta(d(n+k)) 。

当 dd 为常数且 k=O(n)k=O(n) 时, 基数排序具有线性的时间代价。在更一般的情况中, 我们可以灵活地决定如何将每个关键字分解成若干位。

引理 8.4: 给定一个 bb 位数和任何正整数 r⩽br \leqslant b, 如果 RADIX-SORT 使用的稳定排序算法对数据取值区间是 00 到 kk 的输入进行排序耗时 Θ(n+k)\Theta(n+k), 那么它就可以在 Θ((b/r)(n+2r))\Theta\left((b / r)\left(n+2^{r}\right)\right) 时间内将这些数排好序。

证明: 对于一个值 r⩽br \leqslant b, 每个关键字可以看做 d=⌈b/r⌉d=\lceil b / r\rceil 个 rr 位数。每个数都是在 00 到 2r−12^{r}-1 区间内的一个整数, 这样就可以采用计数排序, 其中 k=2r−1k=2^{r}-1 。(例如, 我们可以将一个 32 位的字看做是 4 个 8 位的数, 于是有 b=32,r=8,k=2r−1=255b=32, r=8, k=2^{r}-1=255 和 d=b/r=4d=b / r=4 )。每一轮排序花费时间为 Θ(n+k)=Θ(n+2r)\Theta(n+k)=\Theta\left(n+2^{r}\right), 计数排序花费的总时间代价为 Θ(d(n+2r))=Θ((b/r)(n+2r))\Theta\left(d\left(n+2^{r}\right)\right)=\Theta\left((b / r)\left(n+2^{r}\right)\right) 。

对于给定的 nn 和 bb, 我们希望所选择的 r(r⩽b)r(r \leqslant b) 值能够最小化表达式 (b/r)(n+2r)(b / r)\left(n+2^{r}\right) 。如果 b<b< ⌊lg⁡n⌋\lfloor\lg n\rfloor, 则对于任何满足 r⩽br \leqslant b 的 rr, 都有 (n+2r)=Θ(n)\left(n+2^{r}\right)=\Theta(n) 。显然, 选择 r=br=b 得到的时间代价为 (b/b)(n+2b)=Θ(n)(b / b)\left(n+2^{b}\right)=\Theta(n), 这一结果是渐近意义上最优的。如果 b⩾⌊lg⁡n⌋b \geqslant\lfloor\lg n\rfloor, 选择 r=⌊lg⁡n⌋r=\lfloor\lg n\rfloor 可以得到偏差不超过常数系数范围内的最优时间代价。下面我们来详细说明这一点。选择 r=⌊lg⁡n⌋r=\lfloor\lg n\rfloor, 得到的运行时间为 Θ(bn/lg⁡n)\Theta(b n / \lg n) 。随着将 rr 的值逐步增大到大于 ⌊lg⁡n⌋\lfloor\lg n\rfloor 后, 分子中的 2r2^{r} 项比分母中的 rr 项增加得快。因此, 将 rr 增大到大于 ⌊lg⁡n⌋\lfloor\lg n\rfloor 后, 得到的时间代价为 Ω(bn/lg⁡n)\Omega(b n / \lg n) 。反之, 如果将 rr 减小到 ⌊lg⁡n⌋\lfloor\lg n\rfloor 之下, 则 b/rb / r 项会变大, 而 n+2rn+2^{r} 项仍保持为 Θ(n)\Theta(n) 。

基数排序是否比基于比较的排序算法 (如快速排序) 更好呢? 通常情况, 如果 b=O(lg⁡n)b=O(\lg n), 而且我们选择 r≈lg⁡nr \approx \lg n, 则基数排序的运行时间为 Θ(n)\Theta(n) 。这一结果看上去要比快速排序的期望运行时间代价 Θ(nlg⁡n)\Theta(n \lg n) 更好一些。但是, 在这两个表达式中, 隐含在 Θ\Theta 符号背后的常数项因子是不同的。在处理的 nn 个关键字时, 尽管基数排序执行的循环轮数会比快速排序要少, 但每一轮它所耗费的时间要长得多。哪一个排序算法更合适依赖于具体实现和底层硬件的特性 (例如, 快速排序通常可以比基数排序更有效地使用硬件的缓存), 以及输入数据的特征。此外, 利用计数排序作为中间稳定排序的基数排序不是原址排序, 而很多 Θ(nlg⁡n)\Theta(n \lg n) 时间的比较排序是原址排序。因此, 当主存的容量比较宝贵时, 我们可能会更倾向于像快速排序这样的原址排序算法。

性质

稳定性

基数排序是一种稳定的排序算法。

时间复杂度

一般来说,如果每个关键字的值域都不大,就可以使用 计数排序 作为内层排序,此时的复杂度为 O(kn+∑i=1kwi)O(kn+\sum\limits_{i=1}^k w_i),其中 wiw_i 为第 ii 关键字的值域大小。如果关键字值域很大,就可以直接使用基于比较的 O(nklog⁡n)O(nk\log n) 排序而无需使用基数排序了。

空间复杂度

基数排序的空间复杂度为 O(k+n)O(k+n)。

算法实现

伪代码

1Input. An array A consisting of n elements, where each element has k keys.2Output. Array A will be sorted in nondecreasing order stably.3Method. 4for i←k down to 15sort A into nondecreasing order by the i-th key stably\begin{array}{ll} 1 & \textbf{Input. } \text{An array } A \text{ consisting of }n\text{ elements, where each element has }k\text{ keys.}\\ 2 & \textbf{Output. } \text{Array }A\text{ will be sorted in nondecreasing order stably.} \\ 3 & \textbf{Method. } \\ 4 & \textbf{for }i\gets k\textbf{ down to }1\\ 5 & \qquad\text{sort }A\text{ into nondecreasing order by the }i\text{-th key stably} \end{array}

C++

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
const int N = 100010;
const int W = 100010;
const int K = 100;

int n, w[K], k, cnt[W];

struct Element {
int key[K];
bool operator<(const Element& y) const {
// 两个元素的比较流程
for (int i = 1; i <= k; ++i) {
if (key[i] == y.key[i]) continue;
return key[i] < y.key[i];
}
return false;
}
} a[N], b[N];

void counting_sort(int p) {
memset(cnt, 0, sizeof(cnt));
for (int i = 1; i <= n; ++i) ++cnt[a[i].key[p]];
for (int i = 1; i <= w[p]; ++i) cnt[i] += cnt[i - 1];
// 为保证排序的稳定性,此处循环i应从n到1
// 即当两元素关键字的值相同时,原先排在后面的元素在排序后仍应排在后面
for (int i = n; i >= 1; --i) b[cnt[a[i].key[p]]--] = a[i];
memcpy(a, b, sizeof(a));
}

void radix_sort() {
for (int i = k; i >= 1; --i) {
// 借助计数排序完成对关键字的排序
counting_sort(i);
}
}

实际上并非必须从后往前枚举才是稳定排序,只需对 cnt 数组进行等价于 std::exclusive_scan 的操作即可。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
title: 例题 [洛谷 P1177 【模板】快速排序](https://www.luogu.com.cn/problem/P1177)

给出 $n$ 个正整数,从小到大输出。

```cpp
#include <algorithm>
#include <iostream>
#include <utility>

void radix_sort(int n, int a[]) {
int *b = new int[n]; // 临时空间
int *cnt = new int[1 << 8];
int mask = (1 << 8) - 1;
int *x = a, *y = b;
for (int i = 0; i < 32; i += 8) {
for (int j = 0; j != (1 << 8); ++j) cnt[j] = 0;
for (int j = 0; j != n; ++j) ++cnt[x[j] >> i & mask];
for (int sum = 0, j = 0; j != (1 << 8); ++j) {
// 等价于 std::exclusive_scan(cnt, cnt + (1 << 8), cnt, 0);
sum += cnt[j], cnt[j] = sum - cnt[j];
}
for (int j = 0; j != n; ++j) y[cnt[x[j] >> i & mask]++] = x[j];
std::swap(x, y);
}
delete[] cnt;
delete[] b;
}

int main() {
std::ios::sync_with_stdio(false);
std::cin.tie(0);
int n;
std::cin >> n;
int *a = new int[n];
for (int i = 0; i < n; ++i) std::cin >> a[i];
radix_sort(n, a);
for (int i = 0; i < n; ++i) std::cout << a[i] << ' ';
delete[] a;
return 0;
}

参考资料与注释

Thomas H. Cormen, Charles E. Leiserson, Ronald L. Rivest, and Clifford Stein.Introduction to Algorithms(3rd ed.). MIT Press and McGraw-Hill, 2009. ISBN 978-0-262-03384-8. “8.3 Radix sort”, pp. 199.


桶排序

桶排序(英文:Bucket sort)是排序算法的一种,适用于待排序数据值域较大但分布比较均匀的情况。

工作原理

桶排序按下列步骤进行:

  1. 设置一个定量的数组当作空桶;
  2. 遍历序列,并将元素一个个放到对应的桶中;
  3. 对每个不是空的桶进行排序;
  4. 从不是空的桶里把元素再放回原来的序列中。

算法导论详解

桶排序 (bucket sort) 假设输入数据服从均匀分布, 平均情况下它的时间代价为 O(n)O(n) 。与计数排序类似, 因为对输入数据作了某种假设, 桶排序的速度也很快。具体来说, 计数排序假设输入数据都属于一个小区间内的整数, 而桶排序则假设输入是由一个随机过程产生, 该过程将元素均匀、独立地分布在 [0,1)[0,1) 区间上。

桶排序将 [0,1)[0,1) 区间划分为 nn 个相同大小的子区间, 或称为桶。然后, 将 nn 个输入数分别放 到各个桶中。因为输入数据是均匀、独立地分布在 [0,1)[0,1) 区间上, 所以一般不会出现很多数落在同一个桶中的情况。为了得到输出结果, 我们先对每个桶中的数进行排序, 然后遍历每个桶, 按照次序把各个桶中的元素列出来即可。

在桶排序的代码中, 我们假设输入是一个包含 nn 个元素的数组 AA, 且每个元素 A[i]A[i] 满足 0⩽A[i]<10 \leqslant A[i]<1 。此外, 算法还需要一个临时数组 B[0..n−1]B[0 . . n-1] 来存放链表 (即桶), 并假设存在一种用于维护这些链表的机制。

 BUCKET-SORT (A)1n=A. length 2 let B[0..n−1] be a new array 3 for i=0 to n−14 make B[i] an empty list 5 for i=1 to n6 insert A[i] into list B[⌊nA[i]]]7 for i=0 to n−18 sort list B[i] with insertion sort 9 concatenate the lists B[0],B[1],⋯ ,B[n−1] together in order \begin{aligned} &\text { BUCKET-SORT }(A) \\ &1 \quad n=A \text {. length } \\ &2 \quad \text { let } B[0 . . n-1] \text { be a new array } \\ &3 \quad \text { for } i=0 \text { to } n-1 \\ &4 \quad \qquad \text { make } B[i] \text { an empty list } \\ &5 \quad \text { for } i=1 \text { to } n \\ &6 \quad \qquad \text { insert } A[i] \text { into list } B[\lfloor n A[i]]] \\ &7 \quad \text { for } i=0 \text { to } n-1 \\ &8 \quad \qquad \text { sort list } B[i] \text { with insertion sort } \\ &9 \quad \text { concatenate the lists } B[0], B[1], \cdots, B[n-1] \text { together in order } \end{aligned}

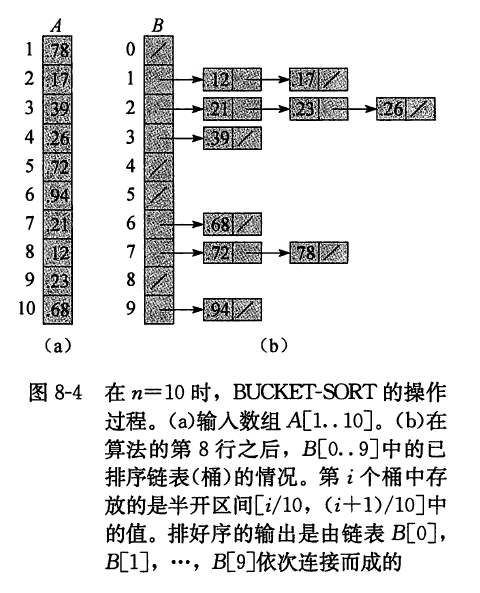
下图显示了在一个包含 10 个元素的输入数组上的桶排序过程。

为了验证算法的正确性, 我们先来看看两个元 素 A[i]A[i] 和 A[j]A[j] 。不失一般性, 不妨假设 A[i]⩽A[j]A[i] \leqslant A[j] 。由于 ⌊nA[i]⌋⩽⌊nA[j]⌋\lfloor n A[i]\rfloor \leqslant\lfloor n A[j]\rfloor, 元素 A[i]A[i] 或者与A[j]A[j] 被放入同一个桶中, 或者被放入一个下标更小的桶中。如果 A[i]A[i] 和 A[j]A[j] 在同一个桶中, 则第 7∼87 \sim 8 行中的 for 循环会将它们按适当的顺序排列。如果 A[i]A[i] 和 A[j]A[j] 落入了不同的桶中, 则第 9 行会将它们按适当的顺序排列。因此, 桶排序算法是正确的。

现在来分析桶排序的运行时间。我们注意到, 在最坏情况下, 除第 8 行以外, 所有其他各行时间代价都是 O(n)O(n) 。我们还需要分析第 8 行中 nn 次插入排序调用所花费的总时间。

现在来分析调用插入排序的时间代价。假设 nin_{i} 是表示桶 B[i]B[i] 中元素个数的随机变量, 因为 插入排序的时间代价是平方阶的, 所以桶排序的时间代价为:

T(n)=Θ(n)+∑i=0n−1O(ni2)T(n)=\Theta(n)+\sum_{i=0}^{n-1} O\left(n_{i}^{2}\right)

我们现在来分析桶排序在平均情况下的运行时间。通过对输入数据取期望, 我们可以计算出期望的运行时间。对上式两边取期望, 并利用期望的线性性质, 我们有:

E[T(n)]=E[Θ(n)+∑i=0n−1O(ni2)]=Θ(n)+∑i=0n−1E[O(ni2)]( 利用期望的线性性质 )=Θ(n)+∑i=0n−1O(E[ni2])( 利用公式 (C.22))(8.1)\begin{aligned} \mathrm{E}[T(n)] &=\mathrm{E}\left[\Theta(n)+\sum_{i=0}^{n-1} O\left(n_{i}^{2}\right)\right] \\ &=\Theta(n)+\sum_{i=0}^{n-1} \mathrm{E}\left[O\left(n_{i}^{2}\right)\right] \quad(\text { 利用期望的线性性质 }) \\ &=\Theta(n)+\sum_{i=0}^{n-1} O\left(\mathrm{E}\left[n_{i}^{2}\right]\right) \quad(\text { 利用公式 }(\mathrm{C} .22))\qquad (8.1) \end{aligned}

我们断言:

E[ni2]=2−1/n(8.2)\mathrm{E}\left[n_{i}^{2}\right]=2-1 / n \qquad(8.2)

对所有 i=0,1,⋯ ,n−1i=0,1, \cdots, n-1 成立。这一点不足为奇: 因为输入数组 AA 的每一个元素是等概率地落入任意一个桶中, 所以每一个桶 ii 具有相同的期望值 E[ni2]\mathrm{E}\left[n_{i}^{2}\right] 。为了证明公式(8.2), 我们定义指示器随机变量: 对所有 i=0,1,⋯ ,n−1i=0,1, \cdots, n-1 和 j=1,2,⋯ ,nj=1,2, \cdots, n,

Xij=I{A[j] 落入桶 i}X_{i j}=\mathrm{I}\{A[j] \text { 落入桶 } i\}

因此,

ni=∑j=1nXijn_{i}=\sum_{j=1}^{n} X_{i j}

为了计算 E[ni2]\mathrm{E}\left[n_{i}^{2}\right], 我们展开平方项, 并重新组合各项:

E[ni2]=E[(∑j=1nXij)2]=E[∑j=1n∑k=1nXijXik]=E[∑j=1nXij2+∑1⩽j⩽n∑1⩽k⩽nk≠jXijXik]=∑j=1nE[Xij2]+∑1⩽j⩽n∑1≤k⩽nk≠jE[XijXik](8.3)\begin{aligned} \mathrm{E}\left[n_{i}^{2}\right] &=\mathrm{E}\left[\left(\sum_{j=1}^{n} X_{i j}\right)^{2}\right]=\mathrm{E}\left[\sum_{j=1}^{n} \sum_{k=1}^{n} X_{i j} X_{i k}\right]=\mathrm{E}\left[\sum_{j=1}^{n} X_{i j}^{2}+\sum_{1 \leqslant j \leqslant n} \sum_{1 \leqslant k \leqslant n \atop k \neq j} X_{i j} X_{i k}\right] \\ &=\sum_{j=1}^{n} \mathrm{E}\left[X_{i j}^{2}\right]+\sum_{1 \leqslant j \leqslant n} \sum_{1 \leq k \leqslant n \atop k \neq j} \mathrm{E}\left[X_{i j} X_{i k}\right]\qquad(8.3) \end{aligned}

其中, 最后一行是根据数学期望的线性性质得出的。我们分别计算这两项累加和, 指示器随机变量 XijX_{i j} 为 1 的概率是 1/n1 / n, 其他情况下是 0 。于是有:

E[Xij2]=12⋅1n+02⋅(1−1n)=1n\mathrm{E}\left[X_{i j}^{2}\right]=1^{2} \cdot \frac{1}{n}+0^{2} \cdot\left(1-\frac{1}{n}\right)=\frac{1}{n}

当 k≠jk \neq j 时, 随机变量 XijX_{i j} 和 XikX_{i k} 是独立的, 因此有:

E[XijXik]=E[Xij]E[Xik]=1n⋅1n=1n2\mathrm{E}\left[X_{i j} X_{i k}\right]=\mathrm{E}\left[X_{i j}\right] \mathrm{E}\left[X_{i k}\right]=\frac{1}{n} \cdot \frac{1}{n}=\frac{1}{n^{2}}

将这两个期望值带入公式 (8.3), 我们得到:

E[ni2]=∑j=1n1n+∑1⩽j⩽n∑1≤knk≠j1n2=n⋅1n+n(n−1)⋅1n2=1+n−1n=2−1n\mathrm{E}\left[n_{i}^{2}\right]=\sum_{j=1}^{n} \frac{1}{n}+\sum_{1 \leqslant j \leqslant n} \sum_{1 \leq k n \atop k \neq j} \frac{1}{n^{2}}=n \cdot \frac{1}{n}+n(n-1) \cdot \frac{1}{n^{2}}=1+\frac{n-1}{n}=2-\frac{1}{n}

到此, 公式(8.2)得证。

利用公式 (8.1) 中的期望值, 我们可以得出结论: 桶排序的期望运行时间为

Θ(n)+n⋅O(2−1/n)=Θ(n)\Theta(n)+n \cdot O(2-1 / n)=\Theta(n)

即使输入数据不服从均匀分布, 桶排序也仍然可以线性时间内完成。只要输入数据满足下列性质:所有桶的大小的平方和与总的元素数呈线性关系, 那么通过公式 (8.1), 我们就可以知 道: 桶排序仍然能在线性时间完成。

性质

稳定性

如果使用稳定的内层排序,并且将元素插入桶中时不改变元素间的相对顺序,那么桶排序就是一种稳定的排序算法。

由于每块元素不多,一般使用插入排序。此时桶排序是一种稳定的排序算法。

时间复杂度

桶排序的平均时间复杂度为 O(n+n2/k+k)O(n + n^2/k + k)(将值域平均分成 nn 块 + 排序 + 重新合并元素),当 k≈nk\approx n 时为 O(n)O(n)。

桶排序的最坏时间复杂度为 O(n2)O(n^2)。

算法实现

C++

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
// C++ Version
const int N = 100010;

int n, w, a[N];
vector<int> bucket[N];

void insertion_sort(vector<int>& A) {
for (int i = 1; i < A.size(); ++i) {
int key = A[i];
int j = i - 1;
while (j >= 0 && A[j] > key) {
A[j + 1] = A[j];
--j;
}
A[j + 1] = key;
}
}

void bucket_sort() {
int bucket_size = w / n + 1;
for (int i = 0; i < n; ++i) {
bucket[i].clear();
}
for (int i = 1; i <= n; ++i) {
bucket[a[i] / bucket_size].push_back(a[i]);
}
int p = 0;
for (int i = 0; i < n; ++i) {
insertion_sort(bucket[i]);
for (int j = 0; j < bucket[i].size(); ++j) {
a[++p] = bucket[i][j];
}
}
}

参考资料与注释

Bucket sort - Wikipedia


归并排序

归并排序(英语:merge sort)是一种采用了 分治 思想的排序算法。

工作原理

归并排序分为三个步骤:

  1. 将数列划分为两部分;
  2. 递归地分别对两个子序列进行归并排序;
  3. 合并两个子序列。

不难发现,归并排序的前两步都很好实现,关键是如何合并两个子序列。注意到两个子序列在第二步中已经保证了都是有序的了,第三步中实际上是想要把两个 有序 的序列合并起来。

算法导论详解

分治法

许多有用的算法在结构上是递归的: 为了解决一个给定的问题, 算法一次或多次递归地调 用其自身以解决紧密相关的若干子问题。这些算法典型地遵循分治法的思想: 将原问题分解为几个规模较小但类似于原问题的子问题, 递归地求解这些子问题, 然后再合并这些子问题的解来建立原问题的解。

分治模式在每层递归时都有三个步骤:

  1. 分解原问题为若干子问题, 这些子问题是原问题的规模较小的实例。
  2. 解决这些子问题, 递归地求解各子问题。然而, 若子问题的规模足够小, 则直接求解。
  3. 合并这些子问题的解成原问题的解。

归并排序算法完全遵循分治模式。直观上其操作如下:

  1. 分解: 分解待排序的 nn 个元素的序列成各具 n/2n / 2 个元素的两个子序列。
  2. 解决: 使用归并排序递归地排序两个子序列。
  3. 合并: 合并两个已排序的子序列以产生已排序的答案。

当待排序的序列长度为 1 时, 递归“开始回升”, 在这种情况下不要做任何工作, 因为长度为 1 的每个序列都已排好序。

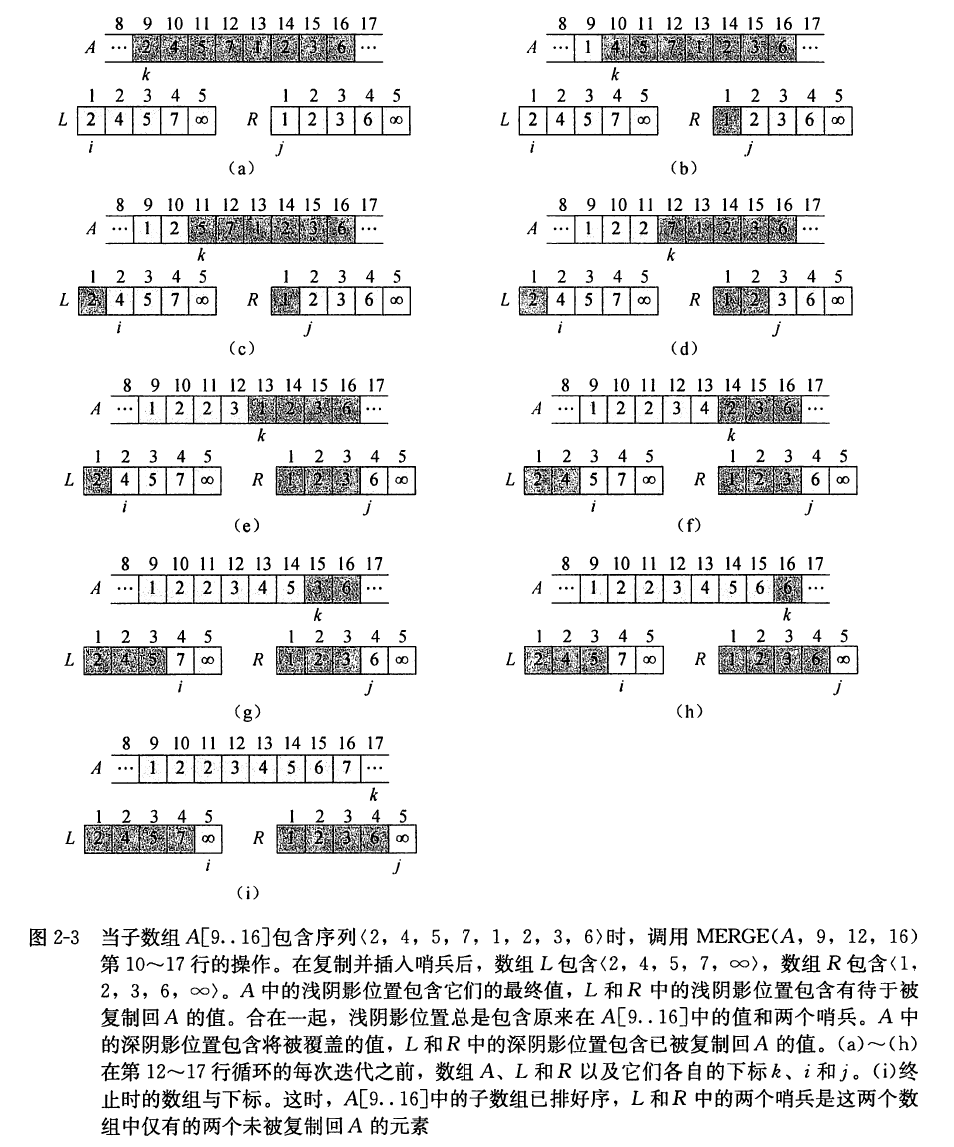
归并排序算法的关键操作是“合并”步骤中两个已排序序列的合并。我们通过调用一个辅助过 程 MERGE(A,p,q,r)MERGE(A, p, q, r) 来完成合并, 其中 AA 是一个数组, pp 、qq 和 rr 是数组下标, 满足 p⩽q<rp \leqslant q<r 。该过程假设子数组 A[p..q]A[p . . q] 和 A[q+1..r]A[q+1 . . r] 都已排好序。它合并这两个子数组形成单一的已排好序的子数组并代替当前的子数组 A[p..r]A[p . . r] 。

过程 MERGEMERGE 需要 Θ(n)\Theta(n) 的时间, 其中 n=r−p+1n=r-p+1 是待合并元素的总数。它按以下方式工作。回到我们玩扑克牌的例子, 假设桌上有两堆牌面朝上的牌, 每堆都已排序, 最小的牌在顶上。我们希望把这两堆牌合并成单一的排好序的输出堆, 牌面朝下地放在桌上。我们的基本步骤包括在牌面朝上的两堆牌的顶上两张牌中选取较小的一张, 将该牌从其堆中移开(该堆的顶上将显露一张新牌)并牌面朝下地将该牌放置到输出堆。重复这个步骤, 直到一个输入堆为空, 这时, 我们只是拿起剩余的输入堆并牌面朝下地将该堆放置到输出堆。因为我们只是比较顶上的两张牌, 所以计算上每个基本步骤需要常量时间。因为我们最多执行 nn 个基本步骤, 所以合并需要 Θ(n)\Theta(n) 的时间。

下面的伪代码实现了上面的思想, 但有一个额外的变化, 以避免在每个基本步骤必须检查是否有堆为空。在每个堆的底部放置一张哨兵牌, 它包含一个特殊的值, 用于简化代码。这里, 我们使用 ∞\infty 作为哨兵值, 结果每当显露一张值为 ∞\infty 的牌, 它不可能为较小的牌, 除非两个堆都已 显露出其哨兵牌。但是, 一旦发生这种情况, 所有非哨兵牌都已被放置到输出堆。因为我们事先知道刚好 r−p+1r-p+1 张牌将被放置到输出堆, 所以一旦已执行 r−p+1r-p+1 个基本步骤, 算法就可以停止。

 MERGE (A,p,q,r)1n1=q−p+12n2=r−q3let L[1…n1+1] and R[1.n2+1] be new arrays 4for i=1 to n15L[i]=A[p+i−1]6for j=1 to n27R[j]=A[q+j]8L[n1+1]=∞9R[n2+1]=∞10i=111j=112for k=p to r13if L[i]⩽R[j]14A[k]=L[i]15i=i+116else17A[k]=R[j]18j=j+1\begin{aligned} &\text { MERGE }(A, p, q, r) \\ 1& \quad n_{1}=q-p+1 \\ 2& \quad n_{2}=r-q \\ 3& \quad \text {let } L\left[1 \ldots n_{1}+1\right] \text { and } R\left[1 . n_{2}+1\right] \text { be new arrays } \\ 4& \quad \text {for } i=1 \text { to } n_{1} \\ 5& \quad \qquad L[i]=A[p+i-1] \\ 6& \quad \text {for } j=1 \text { to } n_{2} \\ 7& \quad \qquad R[j]=A[q+j] \\ 8& \quad L\left[n_{1}+1\right]=\infty \\ 9& \quad R\left[n_{2}+1\right]=\infty \\ 10& \quad i=1 \\ 11& \quad j=1 \\ 12& \quad \text {for } k=p \text { to } r \\ 13& \quad \qquad \text {if } L[i] \leqslant R[j]\\ 14& \quad \qquad \qquad A[k] = L[i]\\ 15& \quad \qquad \qquad i = i + 1\\ 16& \quad \qquad \text{else}\\ 17& \quad \qquad \qquad A[k] = R[j]\\ 18& \quad \qquad \qquad j = j + 1\\ \end{aligned}

过程 MERGEMERGE 的详细工作过程如下: 第 1 行计算子数组 A[p..q]A[p . . q] 的长度 n1n_{1}, 第 2 行计算子数组 A[q+1..r]A[q+1 . . r] 的长度 n2n_{2} 。在第 3 行, 我们创建长度分别为 n1+1n_{1}+1 和 n2+1n_{2}+1 的数组 LL 和 RR ( “左”和“右”), 每个数组中额外的位置将保存哨兵。第 4∼54 \sim 5 行的 for 循环将子数组 A[p..q]A[p . . q] 复制到 L[1…n1]L\left[1 \ldots n_{1}\right], 第 6∼76 \sim 7 行的 for 循环将子数组 A[q+1..r]A[q+1 . . r] 复制到 R[1..n2]R\left[1 . . n_{2}\right] 。第 8∼98 \sim 9 行将哨兵放在数组 LL 和 RR 的末尾。第 10∼1810 \sim 18 行图示在上图中, 通过维持以下循环不变式, 执行 r−p+1r-p+1 个基本步骤:

在开始第 12∼1812 \sim 18 行 for 循环的每次迭代时, 子数组 A[p..k−1]A[p . . k-1] 按从小到大的顺序包含 L[1⋯n1+1]L\left[1 \cdots n_{1}+1\right] 和 R[1⋯n2+1]R\left[1 \cdots n_{2}+1\right] 中的 k−pk-p 个最小元素。进而, L[i]L[i] 和 R[j]R[j] 是各自所在数组中未被复制回数组 AA 的最小元素。

我们必须证明第 12∼1812 \sim 18 行 for 循环的第一次迭代之前该循环不变式成立, 该循环的每次迭 代保持该不变式, 并且循环终止时, 该不变式提供了一种有用的性质来证明正确性。

初始化: 循环的第一次迭代之前, 有 k=pk=p, 所以子数组 A[p..k−1]A[p .. k-1] 为空。这个空的子数组 包含 LL 和 RR 的 k−p=0k-p=0 个最小元素。又因为 i=j=1i=j=1, 所以 L[i]L[i] 和 R[j]R[j] 都是各自所在数组中未被复制回数组 AA 的最小元素。

保持: 为了理解每次迭代都维持循环不变式, 首先假设 L[i]⩽R[j]L[i] \leqslant R[j] 。这时, L[i]L[i] 是未被复制回数组 AA 的最小元素。因为 A[p..k−1]A[p . . k-1] 包含 k−pk-p 个最小元素,所以在第 14 行将 L[i]L[i] 复制到 A[k]A[k] 之后, 子数组 A[p..k]A[p . . k] 将包含 k−p+1k-p+1 个最小元素。增加 kk 的值(在 for 循环中更新)和 ii 的值(在第 15 行中) 后, 为下次迭代重新建立了该循环不变式。反之, 若 L[i]>R[j]L[i]>R[j], 则第 16∼1816 \sim 18 行执行适当的操作来维持该循环不变式。

终止: 终止时 k=r+1k=r+1 。根据循环不变式, 子数组 A[p..k−1]A[p . . k-1] 就是 A[p..r]A[p . . r] 且按从小到大的顺序包含 L[1..n1+1]L\left[1 . . n_{1}+1\right] 和 R[1…n2+1]R\left[1 \ldots n_{2}+1\right] 中的 k−p=r−p+1k-p=r-p+1 个最小元素。数组 LL 和 RR 一起包含 n1+n2+2=r−p+3n_{1}+n_{2}+2=r-p+3 个元素。除两个最大的元素以外, 其他所有元素都已被复制回数组 AA, 这两个最大的元素就是哨兵。

为了理解过程 MERGEMERGE 的运行时间是 Θ(n)\Theta(n), 其中 n=r−p+1n=r-p+1, 注意到, 第 1∼31 \sim 3 行和第 8∼118 \sim 11 行中的每行需要常量时间, 第 4∼74 \sim 7 行的 for 循环需要 Θ(n1+n2)=Θ(n)\Theta\left(n_{1}+n_{2}\right)=\Theta(n) 的时间, 并且, 第 12∼1812 \sim 18 行的 for 循环有 nn 次迭代, 每次迭代需要常量时间。

现在我们可以把过程 MERGEMERGE 作为归并排序算法中的一个子程序来用。下面的过程 MERGE−SORT(A,p,r)MERGE-SORT(A, p, r) 排序子数组 A[p..r]A[p . . r] 中的元素。若 p⩾rp \geqslant r, 则该子数组最多有一个元素, 所以已经排好序。否则, 分解步骤简单地计算一个下标 qq, 将 A[p..r]A[p .. r] 分成两个子数组 A[p..q]A[p .. q] 和 A[q+1..r]A[q+1 .. r], 前者包含 ⌈n/2⌉\lceil n / 2\rceil 个元素, 后者包含 ⌊n/2⌋\lfloor n / 2\rfloor 个元素。

MERGE-SORT (A,p,r)1if p⩾rreturn2q=⌊(p+r)/2⌋3MERGE-SORT (A,p,q)4MERGE-SORT (A,q+1,r)5MERGE(A,p,q,r)\begin{aligned} &\text {MERGE-SORT }(A, p, r) \\ &1 \quad \text {if } p \geqslant r \quad return\\ &2 \quad q=\lfloor(p+r) / 2\rfloor \\ &3 \quad \text {MERGE-SORT }(A, p, q) \\ &4 \quad \text {MERGE-SORT }(A, q+1, r) \\ &5 \quad \text{MERGE}(A, p, q, r) \end{aligned}

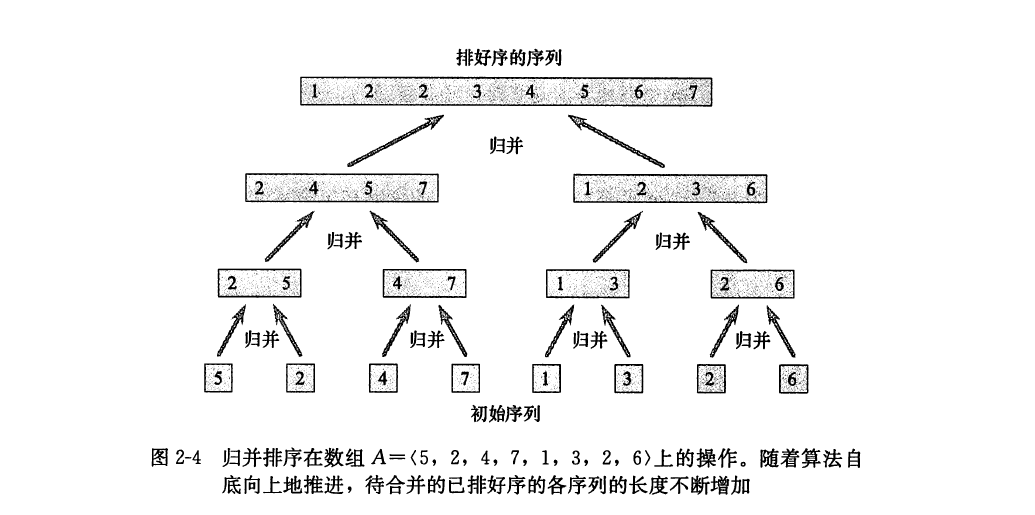
为了排序整个序列 A=⟨A[1],A[2],⋯ ,A[n]⟩A=\langle A[1], A[2], \cdots, A[n]\rangle, 我们执行初始调用 MERGE−SORT(A,  1,  A.length)MERGE-SORT(A,\;1,\;A.length), 这里再次有 A.length=nA.length=n 。下图自底向上地说明了当 nn 为 2 的幂时该过程的操作。算法由以下操作组成: 合并只含 1 项的序列对形成长度为 2 的排好序的序列, 合并长度为 2 的序列对形成长度为 4 的排好序的序列, 依此下去, 直到长度为 n/2n / 2 的两个序列被合并最终形成长度 为 nn 的排好序的序列。

分析分治算法

当一个算法包含对其自身的递归调用时, 我们往往可以用递归方程或递归式来描述其运行时间, 该方程根据在较小输入上的运行时间来描述在规模为 nn 的问题上的总运行时间。然后, 我 们可以使用数学工具来求解该递归式并给出算法性能的界。

分治算法运行时间的递归式来自基本模式的三个步骤。如前所述, 我们假设 T(n)T(n) 是规模为 nn 的一个问题的运行时间。若问题规模足够小, 如对某个常量 cc ,n⩽cn \leqslant c, 则直接求解需要常量时间, 我们将其写作 Θ(1)\Theta(1) 。假设把原问题分解成 aa 个子问题, 每个子问题的规模是原问题的 1/b1 / b 。 (对归并排序, aa 和 bb 都为 2 , 然而, 我们将看到在许多分治算法中, a≠ba \neq b ) 为了求解一个规模为 n/bn / b 的子问题, 需要 T(n/b)T(n / b) 的时间, 所以需要 aT(n/b)a T(n / b) 的时间来求解 aa 个子问题。如果分解问题成子问题需要时间 D(n)D(n), 合并子问题的解成原问题的解需要时间 C(n)C(n), 那么得到递归式:

T(n)={Θ(1) 若 n⩽caT(n/b)+D(n)+C(n) 其他 T(n)= \begin{cases}\Theta(1) & \text { 若 } n \leqslant c \\ a T(n / b)+D(n)+C(n) & \text { 其他 }\end{cases}

在第 4 章中, 我们将看到如何求解这类常见的递归式。

归并排序算法的分析

虽然 MERGE−SORTMERGE-SORT 的伪代码在元素的数量不是偶数时也能正确地工作, 但是, 如果假定原问题规模是 2 的幂, 那么基于递归式的分析将被简化。这时每个分解步骤将产生规模刚好为 n/2n / 2 的两个子序列。在第 4 章, 我们将看到这个假设不影响递归式解的增长量级。

下面我们分析建立归并排序 nn 个数的最坏情况运行时间 T(n)T(n) 的递归式。归并排序一个元素 需要常量时间。当有 n>1n>1 个元素时, 我们分解运行时间如下:

分解: 分解步骤仅仅计算子数组的中间位置, 需要常量时间, 因此, D(n)=Θ(1)D(n)=\Theta(1) 。

解决: 我们递归地求解两个规模均为 n/2n / 2 的子问题, 将贡献 2T(n/2)2 T(n / 2) 的运行时间。

合并: 我们已经注意到在一个具有 nn 个元素的子数组上过程 MERGEMERGE 需要 Θ(n)\Theta(n) 的时间, 所以 C(n)=Θ(n)C(n)=\Theta(n) 。

当为了分析归并排序而把函数 D(n)D(n) 与 C(n)C(n) 相加时, 我们是在把一个 Θ(n)\Theta(n) 函数与另一个 Θ(1)\Theta(1) 函数相加。相加的和是 nn 的一个线性函数, 即 Θ(n)\Theta(n) 。把它与来自 “解决”步骤的项 2T(n/2)2 T(n / 2) 相加, 将给出归并排序的最坏情况运行时间 T(n)T(n) 的递归式:

(2.1)T(n)={Θ(1) 若 n=12T(n/2)+Θ(n) 若 n>1(2.1) \qquad T(n)= \begin{cases}\Theta(1) & \text { 若 } n=1 \\ 2 T(n / 2)+\Theta(n) & \text { 若 } n>1\end{cases}

在第 4 章, 我们将看到“主定理”, 可以用该定理来证明 T(n)T(n) 为 Θ(nlg⁡n)\Theta(n \lg n), 其中 lg⁡n\lg n 代表 log⁡2n\log _{2} n 。因为对数函数比任何线性函数增长要慢, 所以对足够大的输入, 在最坏情况下, 运行时间为 Θ(nlg⁡n)\Theta(n \lg n) 的归并排序将优于运行时间为 Θ(n2)\Theta\left(n^{2}\right) 的插入排序。

为了直观地理解递归式 (2.1) 的解为什么是 T(n)=Θ(nlg⁡n)T(n)=\Theta(n \lg n), 我们并不需要主定理。把递归式 (2.1) 重写为:

(2.2)T(n)={c 若 n=12T(n/2)+cn 若 n>1(2.2) \qquad T(n)= \begin{cases}c & \text { 若 } n=1 \\ 2 T(n / 2)+c n & \text { 若 } n>1\end{cases}

其中常量 cc 代表求解规模为 1 的问题所需的时间以及在分解步骤与合并步骤处理每个数组元素所需的时间。

相同的常量一般不可能刚好既代表求解规模为 1 的问题的时间又代表在分解步骤与合并步骤处理每个数组元素的时间。通过假设 cc 为这两个时间的较大者并认为我们的递归式将给出运行时间的一个上界, 或者通过假设 cc 为这两个时间的较小者并认为我们的递归式将给出运行时间的一个下界, 我们可以回避这个问题。两个界的阶都是 nlg⁡nn \lg n, 合在一起将给出运行时间为 Θ(nlg⁡n)\Theta(n \lg n) 。

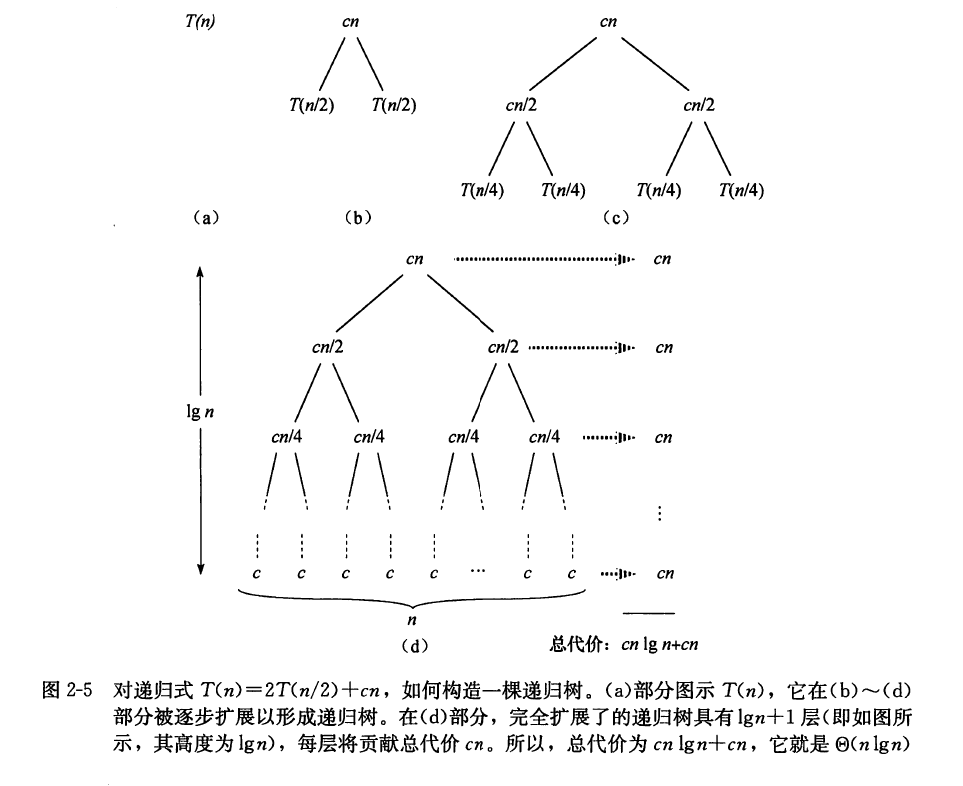
上图图示了如何求解递归式(2.2)。为方便起见, 假设 nn 刚好是 2 的幂。图的 (a) 部分图示 了 T(n)T(n), 它在 (b) 部分被扩展成一棵描绘递归式的等价树。项 cnc n 是树根(在递归的顶层引起的代价), 根的两棵子树是两个较小的递归式 T(n/2)T(n / 2) 。© 部分图示了通过扩展 T(n/2)T(n / 2) 再推进一步的过程。在第二层递归中, 两个子结点中每个引起的代价都是 cn/2c n / 2 。我们通过将其分解成由递归式所确定的它的组成部分来继续扩展树中的每个结点, 直到问题规模下降到 1 , 每个子问题只要代价 cc 。(d) 部分图示了结果递归树。

接着, 我们把穿过这棵树的每层的所有代价相加。顶层具有总代价 cncn , 下一层具有总代价 c(n/2)+c(n/2)=cnc(n / 2)+c(n / 2)=c n, 下一层的下一层具有总代价 c(n/4)+c(n/4)+c(n/4)+c(n/4)=cnc(n / 4)+c(n / 4)+c(n / 4)+c(n / 4)=c n, 等等。一般来说, 顶层之下的第 ii 层具有 2i2^{i} 个结点, 每个结点贡献代价 c(n/2i)c\left(n / 2^{i}\right), 因此, 顶层之下的第 ii 层具有总代价 2ic(n/2i)=cn2^{i} c\left(n / 2^{i}\right)=c n 。底层具有 nn 个结点, 每个结点贡献代价 cc, 该层的总代价为 cnc n 。

图中递归树的总层数为 lg⁡n+1\lg n+1 。其中 nn 是叶数, 对应于输入规模。一种非形式化的归纳论证将证明该断言。 n=1n=1 时出现基本情况, 这时树只有一层。因为 lg⁡1=0\lg 1=0, 所以有 lg⁡n+1\lg n+1 给出了正确的层数。作为归纳假设, 现在假设具有 2i2^{i} 个叶的递归树的层数为 lg⁡2i+1=i+1\lg 2^{i}+1=i+1 (因为对 ii 的任何值都有 lg⁡2i=i\lg 2^{i}=i )。因为我们假设输入规模是 2 的幂, 所以下一个要考虑的输入规模是 2i+12^{i+1} 。具有 n=2i+1n=2^{i+1} 个叶的一棵树比具有 2i2^{i} 个叶的一棵树要多一层, 所以其总层数为 (i+1)+1=(i+1)+1= lg⁡2i+1+1\lg 2^{i+1}+1 。

为了计算递归式 (2.2) 表示的总代价, 我们只要把各层的代价加起来。递归树具有 lg⁡n+1\lg n+1 层, 每层的代价均为 cnc n, 所以总代价为 cn(lg⁡n+1)=cnlg⁡n+cnc n(\lg n+1)=c n \lg n+c n 。忽略低阶项和常量 cc 便给出了期望的结果 Θ(nlg⁡n)\Theta(n \lg n) 。

性质

归并排序是一种稳定的排序算法。

归并排序的最优时间复杂度、平均时间复杂度和最坏时间复杂度均为 O(nlog⁡n)O(n\log n)。

归并排序的空间复杂度为 O(n)O(n)。

代码实现

伪代码

1Input. 待排序的数组A和用作临时存储的数组T2Output. 数组A中的元素将会按照不减的顺序进行稳定排序3Method.4mergeSort(A, T, l, r)5if  l⩾rreturn67mid←⌊l+r2⌋8mergeSort(A, T, ll, mid)9mergeSort(A, T, mid, rr)1011i=l12j=mid+113for each k in the l…r14if j>r or i⩽mid and A[i]⩽A[j]15T[k]=A[i]16i=i+117else18T[k]=A[j]19j=j+120copy T[l…r] to A[l…r]\begin{array}{ll} 1 & \textbf{Input. }\text{待排序的数组}A\text{和用作临时存储的数组}T\\ 2 & \textbf{Output. }\text{数组}A\text{中的元素将会按照不减的顺序进行稳定排序}\\ 3 & \textbf{Method.}\\ 4 & \text{mergeSort}(A,\ T,\ l,\ r)\\ 5 & \qquad \textbf{if}\ \ l \geqslant r \quad return\\ 6 & \\ 7 & \qquad mid \gets \large\lfloor\frac{l+r}{2}\rfloor\\ 8& \qquad\text{mergeSort}(A,\ T,\ ll,\ mid)\\ 9&\qquad\text{mergeSort}(A,\ T,\ mid,\ rr)\\ 10&\\ 11&\qquad i = l\\ 12&\qquad j = mid + 1\\ 13&\qquad\textbf{for}\text{ each } k \text{ in the } l\dots r\\ 14&\qquad\qquad\textbf{if}\ j > r\ or\ i \leqslant mid\ and\ A[i] \leqslant A[j]\\ 15&\qquad\qquad\qquad T[k] = A[i]\\ 16&\qquad\qquad\qquad i = i+1\\ 17&\qquad\qquad\textbf{else}\\ 18&\qquad\qquad\qquad T[k] = A[j]\\ 19&\qquad\qquad\qquad j = j+1\\ 20&\qquad \text{copy }T[l\dots r] \text{ to } A[l\dots r]\\ \end{array}

C++

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
// temp数组是临时存放有序的版本用的。
void mergeSort(int a[], int l, int r) {
if (l >= r) return;

int mid = l + r >> 1;
mergeSort(a, l, mid);
mergeSort(a, mid + 1, r);

int k = l, i = l, j = mid + 1;
while (k <= r) {
if (j > r || i <= mid && a[i] <= a[j]) temp[k++] = a[i++];
else temp[k++] = a[j++];
}
for (int i = l; i <= r; ++i) a[i] = temp[i];
}
// 关键点在于一次性创建数组,避免在每次递归调用时创建,以避免内存分配的耗时。

逆序对

归并排序还可以用来求逆序对的个数。

所谓逆序对,就是对于一个数组 aa,满足 ai>aja_{i} > a_{j} 且 i<ji < j 的数对 (i,j)(i, j)。

代码实现中注释掉的 ans += mid - p 就是在统计逆序对个数。具体来说,算法把靠后的数放到前面了(较小的数放在前面),所以在这个数原来位置之前的、比它大的数都会和它形成逆序对,而这个个数就是还没有合并进去的数的个数,即 mid - p。

另外,逆序对也可以用 树状数组、线段树 等数据结构求解。这三种方法的时间复杂度都是 O(nlog⁡n)O(n \log n)。

外部链接


快速排序

快速排序(英语:Quicksort),又称分区交换排序(英语:partition-exchange sort),简称快排,是一种被广泛运用的排序算法。

基本原理与实现

原理

快速排序的工作原理是通过 分治 的方式来将一个数组排序。

快速排序分为三个过程:

  1. 将数列划分为两部分(要求保证相对大小关系);
  2. 递归到两个子序列中分别进行快速排序;
  3. 不用合并,因为此时数列已经完全有序。

和归并排序不同,第一步并不是直接分成前后两个序列,而是在分的过程中要保证相对大小关系。具体来说,第一步要是要把数列分成两个部分,然后保证前一个子数列中的数都小于后一个子数列中的数。为了保证平均时间复杂度,一般是随机选择一个数 pivotpivot 来当做两个子数列的分界。

之后,维护一前一后两个指针 pp 和 qq,依次考虑当前的数是否放在了应该放的位置(前还是后)。如果当前的数没放对,比如说如果后面的指针 qq 遇到了一个比 pivotpivot 小的数,那么可以交换 pp 和 qq 位置上的数,再把 pp 向后移一位。当前的数的位置全放对后,再移动指针继续处理,直到两个指针相遇。

其实,快速排序没有指定应如何具体实现第一步,不论是选择 pivotpivot 的过程还是划分的过程,都有不止一种实现方法。

第三步中的序列已经分别有序且第一个序列中的数都小于第二个数,所以直接拼接起来就好了。

实现(C++)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
void quicksort(int a[], int l, int r) {
if (l >= r) return;

int pivot = a[l + r >> 1];
int i = l - 1, j = r + 1;
while (i < j) {
while (a[++i] < pivot);
while (a[--j] > pivot);
if (i < j) swap(a[i], a[j]);
}
// [l, j]:<= pivot , [j + 1, r]:>= pivot
quicksort(a, l, j);
quicksort(a, j + 1, r);
}

性质

稳定性

快速排序是一种不稳定的排序算法。

时间复杂度

快速排序的最优时间复杂度和平均时间复杂度为 O(nlog⁡n)O(n\log n),最坏时间复杂度为 O(n2)O(n^2)。

优化

朴素优化思想

如果仅按照上文所述的基本思想来实现快速排序(或者是直接照抄模板)的话,那大概率是通不过 P1177【模板】快速排序 这道模板的。因为有毒瘤数据能够把朴素的快速排序卡成 O(n2)O(n^2)。

所以,我们需要对朴素快速排序思想加以优化。较为常见的优化思路有以下三种。

  • 通过 三数取中(即选取第一个、最后一个以及中间的元素中的中位数) 的方法来选择两个子序列的分界元素(即比较基准)。这样可以避免极端数据(如升序序列或降序序列)带来的退化;
  • 当序列较短时,使用 插入排序 的效率更高;
  • 每趟排序后,将与分界元素相等的元素聚集在分界元素周围,这样可以避免极端数据(如序列中大部分元素都相等)带来的退化。

下面列举了几种较为成熟的快速排序优化方式。

三路快速排序

三路快速排序(英语:3-way Radix Quicksort)是快速排序和 基数排序 的混合。它的算法思想基于 荷兰国旗问题 的解法。

与原始的快速排序不同,三路快速排序在随机选取分界点 mm 后,将待排数列划分为三个部分:小于 mm、等于 mm 以及大于 mm。这样做即实现了将与分界元素相等的元素聚集在分界元素周围这一效果。

三路快速排序在处理含有多个重复值的数组时,效率远高于原始快速排序。其最佳时间复杂度为 O(n)O(n)。

三路快速排序实现起来非常简单,下面给出了一种三路快排的 C++ 实现。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
void quicksort3way(int a[], int l, int r) {
if (l >= r) return;

int pivot = a[l + r >> 1];
// [l, i):< pivot
// [i, j):= pivot
// [j, k]:not sorted
// [k + 1, r]:> pivot
int i = l, j = l, k = r;
while (j <= k) {
if (a[j] < pivot) swap(a[j++], a[i++]);
else if (a[j] > pivot) swap(a[j], a[k--]);
else ++j;
}
// 退出时 j == k + 1,完成一趟三路快排后,序列将分为:
// 小于 pivot 的元素| 等于 pivot 的元素 | 大于 pivot 的元素
// [l, i) | [i, j) | [k + 1, r]
quicksort3way(a, l, i - 1);
quicksort3way(a, k + 1, r);
}

内省排序

内省排序(英语:Introsort 或 Introspective sort)是快速排序和 堆排序 的结合,由 David Musser 于 1997 年发明。内省排序其实是对快速排序的一种优化,保证了最差时间复杂度为 O(nlog⁡n)O(n\log n)。

内省排序将快速排序的最大递归深度限制为 ⌊log⁡2n⌋\lfloor \log_2n \rfloor,超过限制时就转换为堆排序。这样既保留了快速排序内存访问的局部性,又可以防止快速排序在某些情况下性能退化为 O(n2)O(n^2)。

从 2000 年 6 月起,SGI C++ STL 的 stl_algo.h 中 sort() 函数的实现采用了内省排序算法。

线性找第 k 大的数

在下面的代码示例中,第 kk 大的数被定义为序列排成升序时,第 kk 个位置上的数(编号从 0 开始)。

找第 kk 大的数(K-th order statistic),最简单的方法是先排序,然后直接找到第 kk 大的位置的元素。这样做的时间复杂度是 O(nlog⁡n)O(n\log n),对于这个问题来说很不划算。

我们可以借助快速排序的思想解决这个问题。考虑快速排序的划分过程,在快速排序的「划分」结束后,数列 Ap⋯ArA_{p} \cdots A_{r} 被分成了 Ap⋯AqA_{p} \cdots A_{q} 和 Aq+1⋯ArA_{q+1} \cdots A_{r},此时可以按照左边元素的个数(q−p+1q - p + 1)和 kk 的大小关系来判断是只在左边还是只在右边递归地求解。

可以证明,在期望意义下,程序的时间复杂度为 O(n)O(n)。

最坏情况下 O(n)O(n) 算法:Median of medians

实现(C++)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
int quickSelect(int a[], int l, int r, int k) {
if (l >= r) return a[r];

int pivot = a[l + r >> 1];
int i = l - 1, j = r + 1;
while (i < j) {
while (a[++i] < pivot);
while (a[--j] > pivot);
if (i < j) swap(a[i], a[j]);
}
// [l, j]:<= pivot , [j + 1, r]:>= pivot
int n = j - l + 1; // [l, j] 是最小的 n 个数
if (k <= n) return quickSelect(a, l, j, k);
else return quickSelect(a, j + 1, r, k - n);
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
int quickSelect3way(int a[], int l, int r, int idx) {
if (l >= r) return a[r];

int pivot = a[l + r >> 1];
// [l, i):< pivot | [i, j):= pivot|[j, k]:not sorted | [k + 1, r]:> pivot
int i = l, j = l, k = r;
while (j <= k) {
if (a[j] < pivot) swap(a[j++], a[i++]);
else if (a[j] > pivot) swap(a[j], a[k--]);
else ++j;
}
// 退出时 j == k + 1,完成一趟三路快排后,序列将分为:
// 小于 pivot 的元素[l, i)| 等于 pivot 的元素[i, j) | 大于 pivot 的元素[k + 1, r]

// 根据要找的排名与两条分界线的位置,去不同的区间递归查找第 k 大的数
// 如果小于 pivot 的元素个数比 k 多,则第 k 大的元素一定是一个小于 pivot 的元素
// 否则,如果小于 pivot 和等于 pivot 的元素加起来也没有 k 多,则第 k 大的元素一定是一个大于 pivot 的元素
// 否则,pivot 就是第 k 大的元素
int n = i - l; // [l, i) 是小于 pivot 的 n 个数
int m = j - l; // [l, j) 是小于等于 pivot 的 m 个数
if (idx <= i - l) return quickSelect3way(a, l, i - 1, idx);
else if (idx > m) return quickSelect3way(a, k + 1, r, idx - m);
else return pivot;
}

参考资料与注释

C++ 性能榨汁机之局部性原理 - I’m Root lee !

算法实现/排序/快速排序 - 维基教科书,自由的教学读本

三种快速排序以及快速排序的优化

introsort

堆排序

简介

堆排序(英语:Heapsort)是指利用 二叉堆 这种数据结构所设计的一种排序算法。堆排序的适用数据结构为数组。

工作原理

本质是建立在堆上的选择排序。

堆排序的思想就是先将待排序的序列建成大根堆,使得每个父节点的元素大于等于它的子节点。此时整个序列最大值即为堆顶元素,我们将其与末尾元素交换,使末尾元素为最大值,然后再调整堆顶元素使得剩下的 n-1 个元素仍为大根堆,再重复执行以上操作我们即能得到一个有序的序列。

排序过程

首先建立大顶堆,然后将堆顶的元素取出,作为最大值,与数组尾部的元素交换,并维持残余堆的性质;

之后将堆顶的元素取出,作为次大值,与数组倒数第二位元素交换,并维持残余堆的性质;

以此类推,在第 n−1n-1 次操作后,整个数组就完成了排序。

在数组上建立二叉堆

从根节点开始,依次将每一层的节点排列在数组里。

于是有数组中下标为 i 的节点,对应的父结点、左子结点和右子结点如下:

1
2
3
4
// 从 0 开始存
iParent(i) = (i - 1) / 2;
iLeftChild(i) = 2 * i + 1;
iRightChild(i) = 2 * i + 2;

性质

稳定性

同选择排序一样,由于其中交换位置的操作,所以是不稳定的排序算法。

时间复杂度

堆排序的最优时间复杂度、平均时间复杂度、最坏时间复杂度均为 O(nlog⁡n)O(n\log n)。

空间复杂度

由于可以在输入数组上建立堆,所以这是一个原地算法。

代码实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
class Heap {
public:
void build(vector<int> &h, int last) {
// 自底向上建堆,时间复杂度O(n)
// 从最后一个节点的父节点逆序开始 down 以完成堆化 (heapify)
for (int i = last / 2; i >= 0; --i) down(h, i, last);
}

void heapSort(vector<int> &h, int last) {
build(h, last); // 首先建立大顶堆

// 将堆顶的元素取出,作为最大值,与数组尾部的元素交换,并维持残余堆的性质,重复
for (int i = last; i > 0; --i) {
swap(h[0], h[i]);
down(h, 0, i - 1);
}
}

void down(vector<int> &h, int u, int last) {
int fa = u;
while (fa <= last) {
int ls = 2 * fa + 1, rs = 2 * fa + 2;
int t = fa;
if (ls <= last && h[ls] > h[t]) t = ls;
if (rs <= last && h[rs] > h[t]) t = rs;
if (t != fa) { // 子节点比父节点大,交换父子内容,子结点再和孙结点比较
swap(h[fa], h[t]);
fa = t;
} else { // 如果父结点比子结点大,代表调整完毕,直接跳出函数
return;
}
}
}
};

class Solution {
public:
vector<int> sortArray(vector<int>& nums) {
Heap heap;
heap.heapSort(nums, nums.size() - 1);
return nums;
}
};
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
// C++ Version
void sift_down(int arr[], int start, int end) {
// 计算父结点和子结点的下标
int parent = start;
int child = parent * 2 + 1;
while (child <= end) { // 子结点下标在范围内才做比较
// 先比较两个子结点大小,选择最大的
if (child + 1 <= end && arr[child] < arr[child + 1]) child++;
// 如果父结点比子结点大,代表调整完毕,直接跳出函数
if (arr[parent] >= arr[child])
return;
else { // 否则交换父子内容,子结点再和孙结点比较
swap(arr[parent], arr[child]);
parent = child;
child = parent * 2 + 1;
}
}
}

void heap_sort(int arr[], int len) {
// 从最后一个节点的父节点开始 sift down 以完成堆化 (heapify)
for (int i = (len - 1 - 1) / 2; i >= 0; i--) sift_down(arr, i, len - 1);
// 先将第一个元素和已经排好的元素前一位做交换,再重新调整(刚调整的元素之前的元素),直到排序完毕
for (int i = len - 1; i > 0; i--) {
swap(arr[0], arr[i]);
sift_down(arr, 0, i - 1);
}
}

参考资料


希尔排序

希尔排序(英语:Shell sort),也称为缩小增量排序法,是 插入排序 的一种改进版本。希尔排序以它的发明者希尔(英语:Donald Shell)命名。

工作原理

排序对不相邻的记录进行比较和移动:

  1. 将待排序序列分为若干子序列(每个子序列的元素在原始数组中间距相同);
  2. 对这些子序列进行插入排序;
  3. 减小每个子序列中元素之间的间距,重复上述过程直至间距减少为 1。

性质

稳定性

希尔排序是一种不稳定的排序算法。

时间复杂度

希尔排序的最优时间复杂度为 O(n)O(n)。

希尔排序的平均时间复杂度和最坏时间复杂度与间距序列的选取(就是间距如何减小到 1)有关,比如「间距每次除以 3」的希尔排序的时间复杂度是 O(n3/2)O(n^{3/2})。已知最好的最坏时间复杂度为 O(nlog⁡2n)O(n \log^2n)。

空间复杂度

希尔排序的空间复杂度为 O(1)O(1)。

实现

C++

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
// C++ Version
template <typename T>
void shell_sort(T array[], int length) {
int h = 1;
while (h < length / 3) {
h = 3 * h + 1;
}
while (h >= 1) {
for (int i = h; i < length; i++) {
for (int j = i; j >= h && array[j] < array[j - h]; j -= h) {
std::swap(array[j], array[j - h]);
}
}
h = h / 3;
}
}

参考资料与注释

希尔排序 - 维基百科,自由的百科全书


排序相关STL

本页面将简要介绍 C 和 C++ 标准库中实现的排序算法。

除已说明的函数外,本页所列函数默认定义于头文件 <algorithm> 中。

qsort

参见:qsort,std::qsort

该函数为 C 标准库实现的 快速排序,定义在 <stdlib.h> 中。在 C++ 标准库里,该函数定义在 <cstdlib> 中。

qsort 与 bsearch 的比较函数

qsort 函数有四个参数:数组名、元素个数、元素大小、比较规则。其中,比较规则通过指定比较函数来实现,指定不同的比较函数可以实现不同的排序规则。

比较函数的参数限定为两个 const void 类型的指针。返回值规定为正数、负数和 0。

比较函数的一种示例写法为:

1
2
3
4
5
6
7
8
9
10
11
int compare(const void *p1, const void *p2)  // int 类型数组的比较函数
{
int *a = (int *)p1;
int *b = (int *)p2;
if (*a > *b)
return 1; // 返回正数表示 a 大于 b
else if (*a < *b)
return -1; // 返回负数表示 a 小于 b
else
return 0; // 返回 0 表示 a 与 b 等价
}
注意:返回值用两个元素相减代替正负数是一种典型的错误写法,因为这样可能会导致溢出错误。

以下是排序结构体的一个示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
struct eg  // 示例结构体
{
int e;
int g;
};

int compare(const void *p1,
const void *p2) // struct eg 类型数组的比较函数:按成员 e 排序
{
struct eg *a = (struct eg *)p1;
struct eg *b = (struct eg *)p2;
if (a->e > b->e)
return 1; // 返回正数表示 a 大于 b
else if (a->e < b->e)
return -1; // 返回负数表示 a 小于 b
else
return 0; // 返回 0 表示 a 与 b 等价
}
这里也可以看出,等价不代表相等,只代表在此比较规则下两元素等价。

std::sort

参见:std::sort

用法:

1
2
3
4
5
6
// a[0] .. a[n - 1] 为需要排序的数列
// 对 a 原地排序,将其按从小到大的顺序排列
std::sort(a, a + n);

// cmp 为自定义的比较函数
std::sort(a, a + n, cmp);

注意:sort 的比较函数的返回值是 true 和 false,用 true 和 false 表示两个元素的大小(先后)关系,这与 qsort 的三值比较函数的语义完全不同。具体内容详见上方给出的 sort 的文档。

如果要将 sort 简单改写为 qsort,维持排序顺序整体上不变(不考虑等价的元素),需要将返回 true 改为 - 1,返回 false 改为 1。

std::sort 函数是更常用的 C++ 库比较函数。该函数的最后一个参数为二元比较函数,未指定 cmp 函数时,默认按从小到大的顺序排序。

旧版 C++ 标准中仅要求它的 平均 时间复杂度达到 O(nlog⁡n)O(n\log n)。C++11 标准以及后续标准要求它的 最坏 时间复杂度达到 O(nlog⁡n)O(n\log n)。

C++ 标准并未严格要求此函数的实现算法,具体实现取决于编译器。libstdc++ 和 libc++ 中的实现都使用了 内省排序。

std::nth_element

参见:std::nth_element

用法:

1
2
std::nth_element(first, nth, last);
std::nth_element(first, nth, last, cmp);

它重排 [first, last) 中的元素,使得 nth 所指向的元素被更改为 [first, last) 排好序后该位置会出现的元素。这个新的 nth 元素前的所有元素小于或等于新的 nth 元素后的所有元素。

实现算法是未完成的内省排序。

对于以上两种用法,C++ 标准要求它的平均时间复杂度为 O(n)O(n),其中 n 为 std::distance(first, last)。

它常用于构建 K-D Tree。

std::stable_sort

参见:std::stable_sort

用法:

1
2
std::stable_sort(first, last);
std::stable_sort(first, last, cmp);

稳定排序,保证相等元素排序后的相对位置与原序列相同。

时间复杂度为 O(nlog⁡(n)2)O(n\log (n)^2),当额外内存可用时,复杂度为 O(nlog⁡n)O(n\log n)。

std::partial_sort

参见:std::partial_sort

用法:

1
2
3
// mid = first + k
std::partial_sort(first, mid, last);
std::partial_sort(first, mid, last, cmp);

将序列中前 k 元素按 cmp 给定的顺序进行原地排序,后面的元素不保证顺序。未指定 cmp 函数时,默认按从小到大的顺序排序。

复杂度:约 (last−first)log⁡(mid−first)(\mathit{last}-\mathit{first})\log(\mathit{mid}-\mathit{first}) 次应用 cmp。

原理:

std::partial_sort 的思想是:对原始容器内区间为 [first, mid) 的元素执行 make_heap() 操作,构造一个大根堆,然后将 [mid, last) 中的每个元素和 first 进行比较,保证 first 内的元素为堆内的最大值。如果小于该最大值,则互换元素位置,并对 [first, mid) 内的元素进行调整,使其保持最大堆序。比较完之后,再对 [first, mid) 内的元素做一次对排序 sort_heap() 操作,使其按增序排列。注意,堆序和增序是不同的。

自定义比较

参见:运算符重载

内置类型(如 int)和用户定义的结构体允许定制调用 STL 排序函数时使用的比较函数。可以在调用该函数时,在最后一个参数中传入一个实现二元比较的函数。

对于用户定义的结构体,对其使用 STL 排序函数前必须定义至少一种关系运算符,或是在使用函数时提供二元比较函数。通常推荐定义 operator<。因为大部分标准算法默认使用 operator< 进行比较。

示例:

1
2
3
4
int a[1009], n = 10;
// ...
std::sort(a + 1, a + 1 + n); // 从小到大排序
std::sort(a + 1, a + 1 + n, greater<int>()); // 从大到小排序
1
2
3
4
5
6
7
8
9
10
11
12
13
struct data {
int a, b;
bool operator<(const data rhs) const {
return (a == rhs.a) ? (b < rhs.b) : (a < rhs.a);
}
} da[1009];

bool cmp(const data u1, const data u2) {
return (u1.a == u2.a) ? (u1.b > u2.b) : (u1.a > u2.a);
}
// ...
std::sort(da + 1, da + 1 + 10); // 使用结构体中定义的 < 运算符,从小到大排序
std::sort(da + 1, da + 1 + 10, cmp); // 使用 cmp 函数进行比较,从大到小排序

严格弱序

参见:Strict weak orderings

进行排序的运算符必须满足严格弱序,否则会出现不可预料的情况(如运行时错误、无法正确排序)。

严格弱序的要求:

  1. x≮xx \not< x(非自反性)
  2. 若 x<yx < y,则 y≮xy \not< x(非对称性)
  3. 若 x<y,y<zx < y, y < z,则 x<zx < z(传递性)
  4. 若 x≮y,y≮x,y≮z,z≮yx \not< y, y \not< x, y \not< z, z \not< y,则 x≮z,z≮xx \not< z, z \not< x(不可比性的传递性)

常见的错误做法:

  • 使用 <= 来定义排序中的小于运算符。
  • 在调用排序运算符时,读取外部数值可能会改变的数组(常见于最短路算法)。
  • 将多个数的最大最小值进行比较的结果作为排序运算符(如皇后游戏/加工生产调度 中的经典错误)。

外部链接


排序应用

降低时间复杂度

使用排序预处理可以降低求解问题所需要的时间复杂度。

1
2
3
4
5
6
title: 示例:检查给定数列中是否有相等的元素

考虑一个数列,你需要检查其中是否有元素相等。
一个朴素的做法是检查每一个数对,并判断这一对数是否相等。时间复杂度是 $O(n^2)$。
我们不妨先对这一列数排序,之后不难发现:如果有相等的两个数,它们一定在新数列中处于相邻的位置上。这时,只需要 $O(n)$ 地扫一遍新数列了。
总的时间复杂度是排序的复杂度 $O(n\log n)$。

作为查找的预处理

排序是 二分查找 所要做的预处理工作。在排序后使用二分查找,可以以 O(log⁡n)O(\log n) 的时间在序列中查找指定的元素。